
中国经济导报、中国发展网记者 崔立勇
2026中国国际大数据产业博览会不久前在贵阳举行。本届数博会以“词元——数据要素价值释放新路径”为主题,吸引1.6万余名嘉宾注册参会、372家中外企业参展。大会期间,中科曙光发布新一代词元加速方案ParaCache。该方案采用全国产化技术路线,依托曙光ParaStor分布式存储底座,解决大模型“推理越来越慢”、KV Cache“记忆越来越贵”的双重问题。
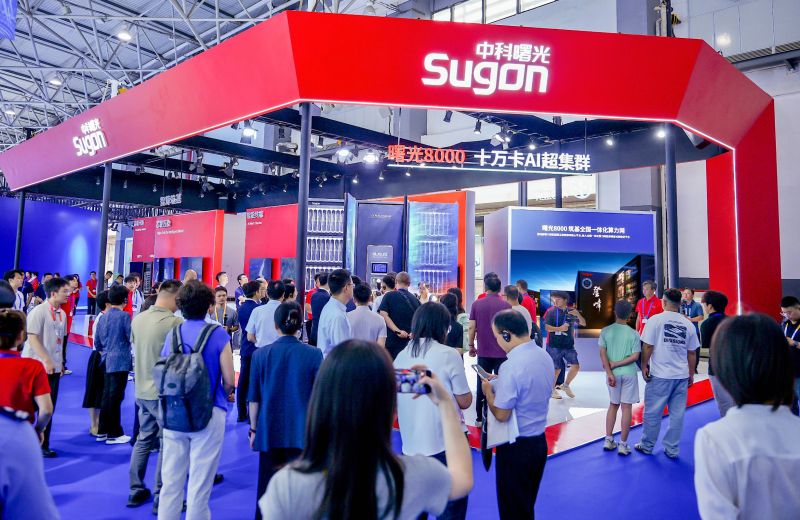
大模型规模化落地,正在把算力消耗的重心从训练推向推理。IDC预测,到2027年中国智能算力规模中推理占比将提高到72.6%。推理是持续性成本,其成本占比已高达80%至90%。这一转变使得推理成本优化成为AI企业的核心竞争力。
然而,推理环节正遭遇双重瓶颈。中科曙光分布式存储产品部总经理石静向记者解释,当前主流大模型采用“自回归”方式逐字生成回答,每生成一个新字,模型要重复计算所有历史内容的键和值向量。处理16K长度的序列,单次推理需执行2.56亿次键值对计算。业界用KV Cache技术来应对:把算好的结果缓存在GPU的HBM显存里,下次直接调用。但KV Cache对显存消耗极大,HBM很快会被撑满。石静指出,KV Cache虽然加速了“思考”,却让“记忆”变得昂贵。与此同时,存储芯片持续紧缺。高盛研报显示,2026年全球DRAM、NAND闪存、HBM的供需缺口分别达到4.9%、4.2%、5.1%,均为2011年以来最高水平。TrendForce预估,2027年HBM合约价格仍可能上涨70%至140%。
ParaCache把已经算过的结果长时间保存下来,下次需要时直接复用。石静说,这套方案的核心思路是“从存数据到存智能”,将KV Cache本身当作一种可复用的数据资产来管理。
ParaCache以曙光ParaStor分布式存储为底座,构建了四级缓存架构。L1是GPU的HBM,L2是CPU的DRAM内存,L3是本地SSD(中科曙光首次把集中式存储FlashNexus纳入这一层),L4是分布式共享存储。热数据留在显存,温数据放内存,冷数据下沉到SSD和分布式存储。石静举例,假如有两个推理应用,一个希望KV Cache保存几分钟就淘汰,另一个要保留到小时级别,可以基于目录设置不同的淘汰策略。
L4层的分布式存储,过去在这个场景里基本只充当冷数据仓库——分布式锁的强一致性导致延迟太大。中科曙光完成多项定向优化:把覆盖写改成追加写以降低延迟,把分布式锁做轻量化处理。同时通过自研的XDS技术(与英伟达GDS相似,但兼容国产AI卡),让AI卡可以直接和分布式存储交互,跳过L2和L3,实现L1到L4的直接卸载和回迁。在L3层级,中科曙光首次将集中式存储FlashNexus纳入本地SSD层,在多计算节点共用一套FlashNexus的场景下,延迟、吞吐量和多请求并发数相较Local SSD均有约2倍的提升。
ParaCache带来的价值可概括为“多、快、好、省”。“多”:高并发场景下,词元吞吐量最大提升27倍。“快”:约12万词元输入下,单轮对话首词元时延最高降低98.5%,降至400毫秒;连续20轮对话中,这一时间由43.1秒降至4.9秒。“好”:原生兼容LMCache——KV缓存管理领域的事实标准,被vLLM、SGLang等主流推理框架广泛采用,企业无需重构技术栈。“省”:可以在内存或SSD配置上节省约三分之一的硬件采购成本。石静分析,这个数字没有办法进行统一评估,“不会像算力那么简单,例如堆砌多少算力,通过卡单体能力乘片数就能达到,它是动态变化的。”
据介绍,ParaCache和LMCache有本质区别。石静解释,LMCache虽然能实现KV Cache在不同推理实例间的卸载,但本质上还是单机版,跨GPU之后则没法共享受,ParaCache做的是跨GPU、跨节点的分布式共享KV缓存池。中科曙光也没有自己“包办”全部,而是与多家主流第三方KV管理软件厂商联合定制开发。
目前,ParaCache已在国内某头部互联网企业在线推理业务中落地,模型开始回答前的平均等待时间降低50%以上;在同等硬件条件下,系统可承载的业务请求也提升数倍。
值得注意的是,中科曙光ParaStor F9000分布式全闪存系统在2026年ISC国际超算大会IO500榜单一举拿下生产型全节点和10节点双榜全球第一。这是中国厂商首次在生产类榜单斩获双料冠军。全节点带宽达26888.39GiB/s,元数据处理性能达232754.76kIOP/s,多项核心指标刷新世界纪录。IO500的“生产型榜单”只收录在真实生产环境中长期稳定运行、满足实际业务负载的存储系统,是衡量存储系统真实应用价值的重要风向标。
在应用场景上,ParaCache最适合“长上下文占比高、有一定量公共重复上下文、并发压力大”的企业。石静举例,在某银行信用卡中心,通过超节点加ParaCache把并发吞吐量提升了3倍;在教科研AI助学知识问答场景,并发程度提升了15倍到20倍。
赛迪顾问《中国分布式存储市场研究报告(2026)》显示,2025年中国分布式存储市场规模达289.4亿元,同比增长46%。中科曙光在AI大模型、具身智能、自动驾驶、教育四个行业斩获中国存储市场第一,其中AI存储连续三年居首。
石静表示,过往中国企业有时跟着国外的技术走,但这两年国内在做各种大规模智算,从计算、存储到网络,国产化的技术和厂商方案层出不穷。ParaCache不是简单提升单张GPU的性能,而是通过减少重复计算,把更多算力用于处理新的任务。过去存储主要负责保存数据,ParaCache进一步将模型已经完成的计算结果纳入存储和复用体系。对于大模型推理而言,少一次重复计算,就意味着少一段等待,也少一份算力消耗。